


Opus 5.5, Fable 5.1, GPT-6, DeepSeek и Grok: цены и скорость
За пять недель вышли Claude Fable 5.1, Opus 5.5 и Sonnet 5.5, GPT-6 Astra, Sol, Luna и GPT-6.1 Sol, Grok 4.7 и DeepSeek V4.1 Flash. Свёл в одну статью прейскуранты API и подписок, независимые замеры скорости и то, сколько денег и минут уходит на одну и ту же задачу. Цифры на 3 октября 2026 года.
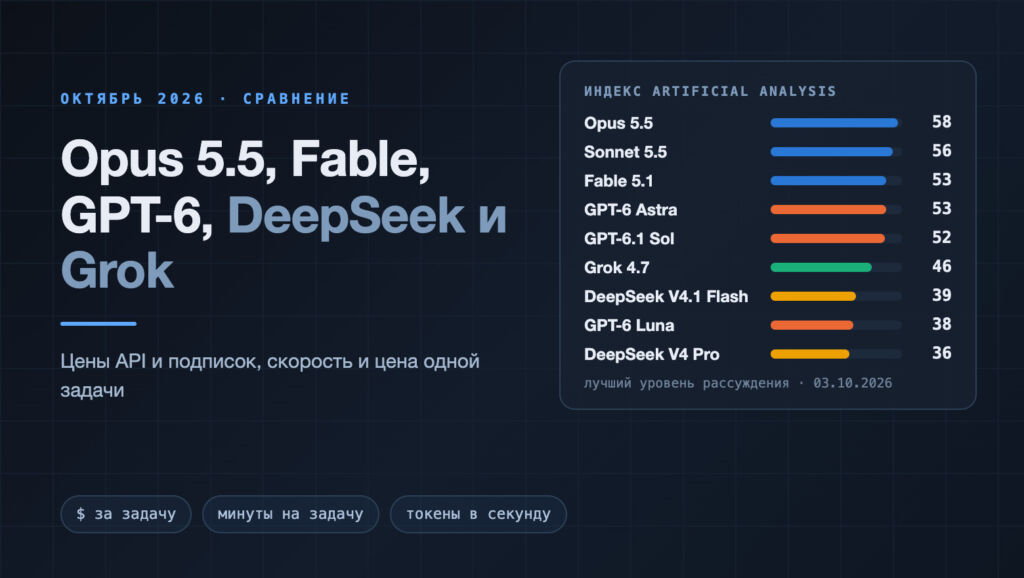
Осень 2026 года получилась самой плотной за всю историю этой гонки. С 1 по 29 сентября вышли релизы у четырёх лабораторий, а цены на токены перестали что-либо объяснять: модели с одинаковым прейскурантом дают счёт, который различается вдвое. Ниже — что именно вышло, откуда берутся цифры в чужих таблицах и почему платить теперь нужно считать по решённым задачам.
Календарь релизов: 1 сентября — 29 сентября
Первого сентября Anthropic выпустила Claude Fable 5.1. Третьего OpenAI показала GPT-6 Astra, 10 сентября DeepSeek выкатила V4.1 Flash без презентации. Двадцать первого сентября подтянулась xAI с Grok 4.7, а 22 сентября вышли сразу Claude Opus 5.5, GPT-6 Sol и GPT-6 Luna. Двадцать восьмого и двадцать девятого сентября добавились Claude Sonnet 5.5 и GPT-6.1 Sol.
Одна модель в этот список не попала: GPT-6.1 Astra так и не выпустили.
Регистрируйся на Pressfeed – получи 3 питча в подарок
Промокод покажем сразу после регистрации.
Почему таблицам производителей верить нельзя
Цифры в пресс-релизах берутся из таблиц самих компаний. Каждая выбирает тесты в пользу своей модели и запускает их на максимальном уровне рассуждения, со своей обвязкой подачи задач и проверки ответов. Один и тот же тест в разных обвязках даёт разные числа.
Пример наглядный: Terminal-Bench 4.0 для Grok 4.7 у xAI — 37,6 %, у Artificial Analysis — 33 %. Разница почти в пять пунктов, и это одна и та же модель на одном и том же тесте. Сравнивать строки из таблиц разных компаний можно только грубо.
Независимые замеры устроены иначе. Artificial Analysis гоняет одинаковые тесты для всех моделей в одних и тех же условиях и сводит десять тестов в общий индекс. Попутно там замеряют скорость вывода, задержку до первого токена, количество выходных токенов и стоимость одной задачи. Лучшей общей линейки сейчас нет, хотя изъян у неё есть: это среднее по больнице, и модель, сильная в узкой нише, в индексе может уступать.
Третий источник — прямые сравнения на одном задании, которые делают издания и блогеры: две-три модели получают одну задачу, а автор засекает время, считает доллары и оценивает результат. К реальной работе это ближе всего, но выборка мизерная: три задания или один «Тетрис» — это иллюстрация, а не статистика.
GPT-6.1 Sol: дешевле, чем кажется по прейскуранту
GPT-6 Sol вышел 22 сентября с ценой $2 за вход и $10 за выход. GPT-6.1 Sol от 29 сентября стоит столько же, но кэш у него $0,10 вместо $0,20, вдвое дешевле. После 272 тысяч токенов включается двойной тариф: $4 на входе и $15 на выходе.
OpenAI говорит, что GPT-6.1 Sol почти догнала Astra. По DeepSWE 1.1 она показала результат Astra, потратив впятеро меньше токенов. К Opus 5.5 прибавка 2,2 пункта в AutomationBench, но в OSWorld 2.0 минус 2,1 пункта от Astra. По фактической точности ошибок на 1,9 % больше, чем у Astra. Artificial Analysis даёт 52 балла, на 1 меньше Astra, а цена задачи ниже Astra в 4,5 раза.
В ChatGPT новая модель доступна только в агенте Work и Codex. В обычный чат она не пришла.
DeepSeek: Flash обошёл Pro и стоит в разы меньше
Финальная V4 Pro вышла в API в середине августа. Параметры — 1,6 триллиона, активных на токен 49 миллиардов, лицензия MIT. Окно миллион токенов, ответ до 384 тысяч.
Летом DeepSeek поднял цены на V4 и ввёл пиковые часы. В пик V4 Pro стоит $1,32 на входе и $3,96 на выходе, вне пика ровно вдвое меньше. Кэш — 4,4 цента в пик. Пик по будням: 01:00–04:00 и 06:00–10:00 UTC, по Москве это 4–7 утра и 9–13 часов.
V4.1 Flash от 10 сентября получила поддержку картинок. Вне пика 15 центов на входе и 60 на выходе, кэш 0,3 цента, в пик всё вдвое дороже. В тот же день объявили, что с 14 сентября запросы V4 Pro пойдут на V4.1 Flash, но затем это отменили. На странице цен V4 Pro работает с прежними ценами, а изменения обещают только с предупреждением заранее.
У Artificial Analysis Flash набирает 39 баллов, Pro — 36. Младшая модель обходит старшую и стоит в разы дешевле.
Считайте цену решённой задачи, а не токена
Прейскурант — это цена слова. Платите вы за решённую задачу, а расход токенов на неё у разных моделей отличается кратно. Размышления при этом оплачиваются по цене выхода.
Artificial Analysis считает среднюю стоимость задачи своего индекса при заданном уровне рассуждения. Самая дорогая задача вышла у Sonnet 5.5 — $7,67 на максимальном уровне. У Fable 5.1 — $7,63, у Opus 5.5 — $5,98.
При этом за токен Sonnet вдвое дешевле Opus и впятеро дешевле Fable. Причина в многословии: прогон индекса у Sonnet 5.5 съел 420 миллионов выходных токенов при медиане класса 81 миллион. У Opus 5.5 — 260 миллионов, у Fable — 190 миллионов.
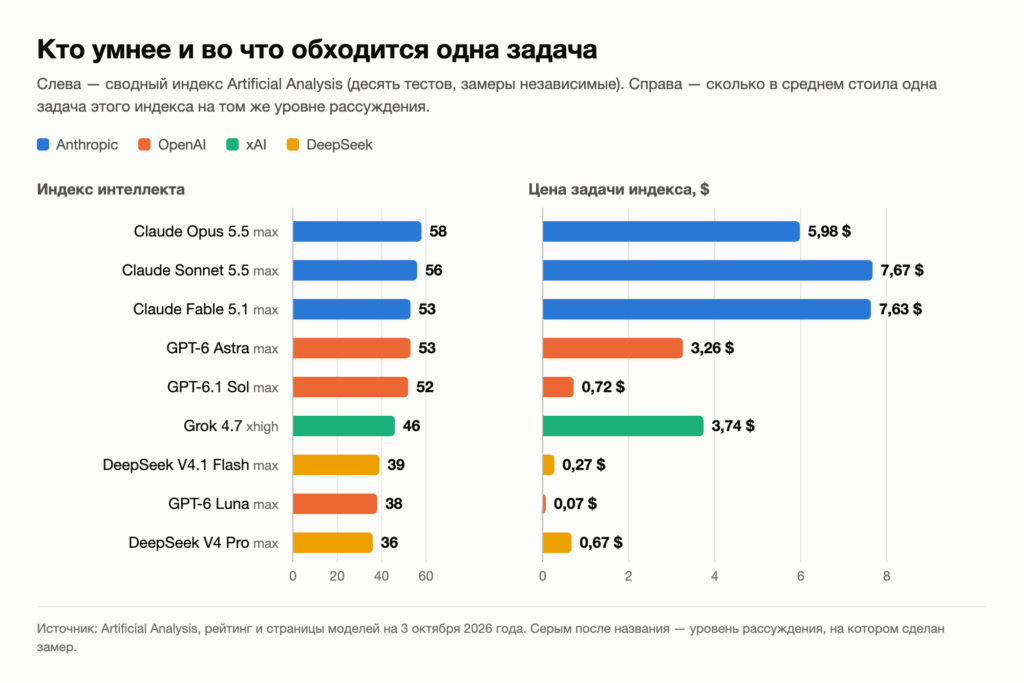
Дальше по списку. GPT-6 Astra: $3,26 за задачу, вдвое дешевле Opus. GPT-6.1 Sol расходует 67 миллионов токенов на прогон и при 52 баллах индекса берёт 72 цента за задачу — лучшее соотношение качества и цены среди моделей выше 50 баллов. Grok 4.7 при прейскуранте в 5 раз дешевле Astra тратит 81 тысячу выходных токенов на задачу против 36 тысяч у Grok 4.6 и стоит $3,74, то есть дороже Astra.
Дешёвый сегмент выглядит так: GPT-6 Luna — 38 баллов за 7 центов, V4.1 Flash — 39 баллов за 27 центов, V4 Pro — 36 баллов за 67 центов. V4 Pro дороже Flash при худшем результате, так что после подорожания это не очевидный выбор.
Вывод простой: одинаковый прейскурант за токен ничего не гарантирует, разница по итоговому счёту легко достигает двух раз. Считайте свою задачу, а не прайс.
В полной версии есть ещё разбор того, откуда берётся разница в скорости печати и времени до первого слова, как устроены подписки и API на длинной дистанции, и как проверить модели на собственных задачах, а не на чужих таблицах.

Комментарии