


Что уже работает по закону об ИИ с 1 сентября 2026 года и что включат в 2027-м
Разобрал по тексту все 13 статей закона 243-ФЗ, карточку законопроекта в базе Госдумы, два новых законопроекта с официальными отзывами и проекты постановлений, о которых писала деловая пресса. Что уже работает, что включится 1 марта 2027 года, почему маркировка ИИ-контента осталась правом, а не обязанностью, и кого закон не касается вовсе. Данные на 17 октября 2026 года.
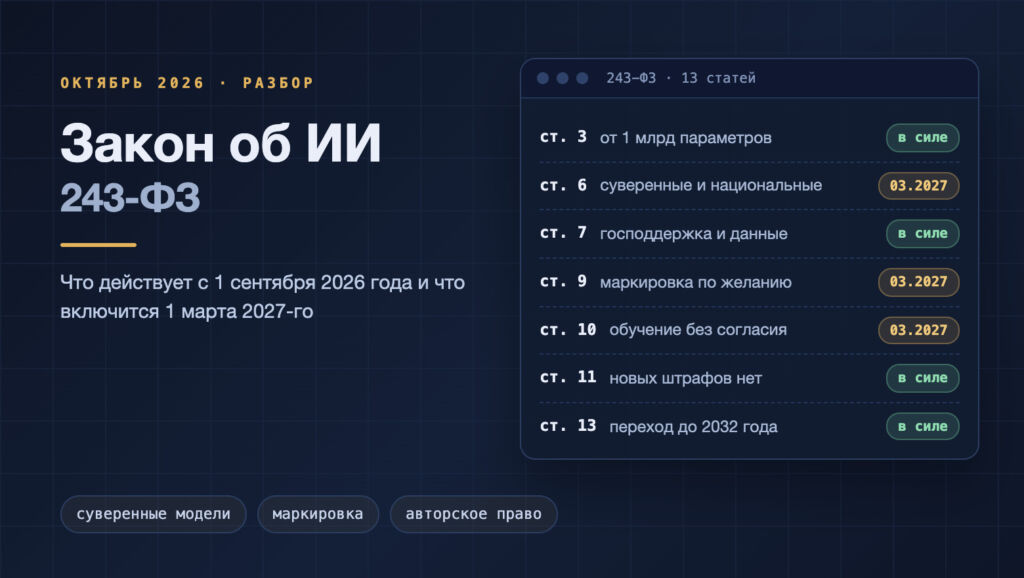
Первый в России закон об искусственном интеллекте применяется с 1 сентября 2026 года. Полное название документа: Федеральный закон от 26 июля 2026 года № 243-ФЗ «О поддержке развития технологий искусственного интеллекта в Российской Федерации». Дальше идёт разбор по статьям: что действует уже сейчас, что заработает 1 марта 2027 года и чего в тексте нет, хотя об этом пишут. Пригодится, если вы работаете с моделями, пишете о них или просто устали от противоречивых новостей.
С момента подписания прошло полтора месяца, и за это время о законе написали сотни раз. Заметная часть таких заметок пересказывает не тот текст. Кто-то уверяет, будто контент от нейросетей придётся маркировать в обязательном порядке. В самом законе такого требования нет.
Отдельные авторы ждут запрета ChatGPT. В документе он даже не упомянут. Ещё один популярный аргумент: 675 тысяч «преступлений с дипфейками» за 2025 год. Число взято из пояснительной записки к законопроекту и охватывает все ИТ-преступления сразу, а дипфейки тут лишь частный случай.
Регистрируйся на Pressfeed – получи 3 питча в подарок
Промокод покажем сразу после регистрации.
Закон я прочитал полностью, а две публикации его текста из разных источников сравнил между собой. Расхождений не нашлось ни в одном слове. Плюс посмотрел, как законопроект описан в базе Госдумы, и мартовскую версию Минцифры, а затем всё, что из неё выпало по дороге.
Ещё два законопроекта внесли уже после подписания, их я читал вместе с официальными отзывами правительства и Верховного суда. Подзаконные акты смотрел по публикациям «Коммерсанта», «Ведомостей» и ComNews. Самих постановлений в финальной редакции в открытом доступе всё ещё нет.
Всё написанное верно на 17 октября 2026 года. Я не юрист, и этот текст не заменяет консультацию. Зато каждое утверждение о законе можно проверить по номеру статьи.
Коротко
Главное укладывается в пять пунктов.
- Закон рамочный и узкий. Его действие распространяется только на крупные модели общего назначения. Это системы от миллиарда параметров, рассчитанные на множество разных задач и годные как основа для другого софта. Оба условия, порог и универсальность, должны выполняться одновременно. Решения поменьше и модели под одну узкую задачу остаются вне рамок. Кредитный скоринг, антифрод и распознавание лиц в список тоже не входят.
- Смысловая основа документа, два статуса моделей. Суверенная считается полностью своей — она размещена в российских дата-центрах. Национальная тоже принадлежит российской компании, однако работать может на чужих компонентах под открытой лицензией. За статусом идут господдержка, доступ к государственным данным и разрешение учиться на чужих произведениях без спроса авторов.
- Маркировка добровольная. С 1 марта 2027 года у крупных площадок появится обязанность дать человеку возможность пометить материал как созданный ИИ. Сам контент при этом помечать никто не требует.
- Штрафов закон не вводит. Нормы об ответственности просто ссылаются на законы, которые уже работают.
- Основная конкретика заработает 1 марта 2027 года, её принесут постановления правительства. Проекты уже обсуждают: где оставят только российские модели, по каким критериям давать статус и обязан ли ИИ-помощник стоять на смартфоне по умолчанию.
До 243-ФЗ модели регулировали по частям, без отдельного закона
Единого закона об ИИ до сентября 2026 года не существовало. Нормы копились отдельными кусками, и именно из-за этой мозаики 243-ФЗ вышел таким коротким. Каждый акт закрывал узкую тему и на общий каркас не претендовал.
- Национальная стратегия развития ИИ. Её утвердили указом президента в 2019 году и обновили в феврале 2024-го. Определение искусственного интеллекта в 243-ФЗ пришло как раз оттуда.
- Экспериментальные правовые режимы. Нормы 258-ФЗ, принятого в 2020 году, дают право временно обходить общие правила внутри пилотных проектов. Тогда же отдельным законом стартовал эксперимент с ИИ в Москве.
- Обезличенные персональные данные. С 1 сентября 2025 года их разрешили обрабатывать в государственной информационной системе без согласия граждан, в том числе для обучения моделей. Вопрос с данными это сняло, правил для самих моделей не добавило.
- Кодекс этики в сфере ИИ. Документ 2021 года и добровольный: под ним подписались крупные компании отрасли.
- Поручение президента от 1 апреля 2025 года № Пр-706. Пункт 5 поручал взвесить, не сделать ли применение ИИ отягчающим обстоятельством. Об этом ещё будет речь ниже, в разделе про ответственность.
Все эти акты говорили о данных, экспериментах и этике. А модели как объекта права не существовало — вплоть до 243-ФЗ.
От первой редакции к итоговой: контроль сменился поддержкой
Минцифры обнародовало первый вариант 18 марта 2026 года. Имя у него было другое: «Об основах государственного регулирования сфер применения технологий искусственного интеллекта». Заработать документ должен был с 1 сентября 2027 года. Рядом с финальной версией это выглядело как свод правил о надзоре.
В марте список выглядел так.
- Модели делились на суверенные, национальные и доверенные. Последние шли в государственные информационные системы и на значимые объекты критической информационной инфраструктуры, проходили проверку ФСБ и ФСТЭК, попадали в реестр.
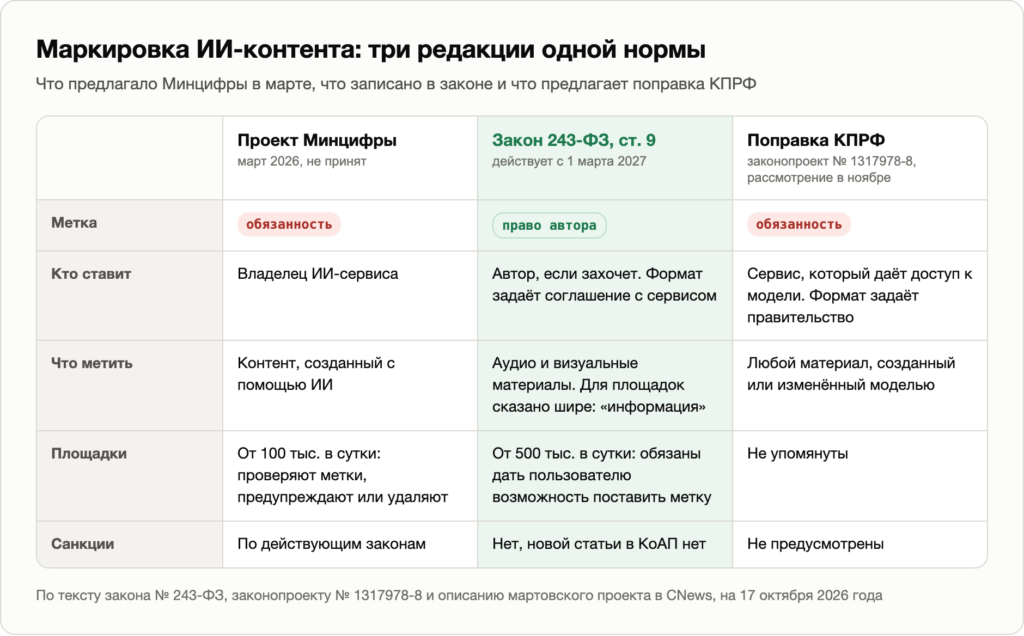
- Владелец ИИ-сервиса обязан был помечать всё, что сервис создал.
- Площадки с аудиторией больше 100 тысяч человек в сутки проверяли метки, а без метки предупреждали автора либо снимали материал.
- Разработчик, оператор и владелец сервиса оценивали риски, не допускали необоснованной дискриминации, тестировали систему и останавливали её при киберугрозе.
- Сервисы с аудиторией больше 500 тысяч человек в сутки попадали под «закон Яровой»: данные хранить и передавать силовым структурам.
- Все участники цепочки отвечали соразмерно вине, когда знали или должны были знать о противоправном результате.
- Трансграничные ИИ-технологии можно было запрещать или ограничивать.
- Дата-центрам под ИИ обещали льготы: бесплатное подключение к сетям, электричество дешевле промышленного тарифа, долгие договоры с предельной ценой.
В апреле документ разобрал Совет при президенте по кодификации и совершенствованию гражданского законодательства. Он счёл, что отдельные нормы расходятся с Гражданским кодексом и расшатывают авторское право.
22 июня правительство вынесло вторую редакцию. В ней осталось 13 страниц и 13 статей, а название стало нынешним. Пропали доверенные модели и реестр, обязательная маркировка и распределение ответственности, ограничения для трансграничных моделей и льготы дата-центрам. Вице-премьер Дмитрий Григоренко объяснял: «Речь не идет о запрете или ограничении доступа к иностранным нейросетям».
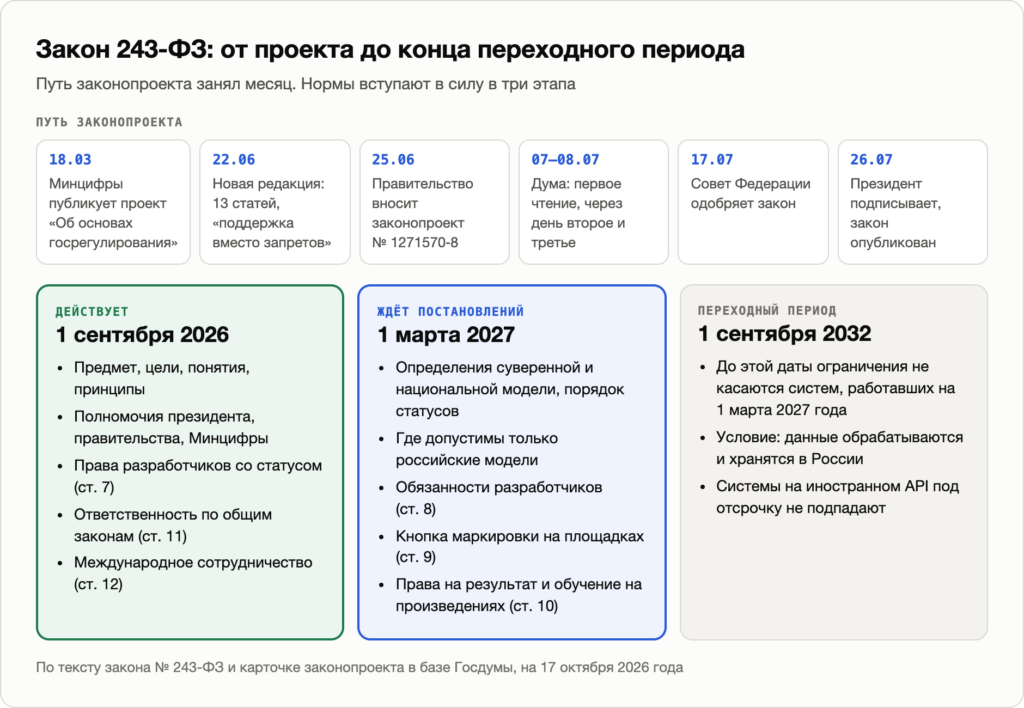
Дальше события понеслись. Хронология по карточке законопроекта № 1271570-8 в базе Госдумы:
- 25 июня 2026 года документ вносит правительство;
- 7 июля первое чтение в Думе, на поправки оставался один день;
- 8 июля сразу второе и третье чтения;
- 17 июля одобрение Совета Федерации;
- 26 июля подпись президента, и в тот же день публикация.
Между внесением и подписью уложился месяц. Ко второму чтению из предмета регулирования выпало слово «использование», остались «разработка, внедрение и применение». «Набор данных» превратился в «состав данных», а «настройка» параметров стала «подбором». У суверенной модели пропала «матрица исходных коэффициентов», требование осталось одно: обучение.
Норму о площадках с кнопкой маркировки переписали иначе. Теперь это не владельцы соцсетей, а владельцы сайтов, информационных систем и программ с аудиторией больше 500 тысяч человек в сутки. Поправку депутата Михаила Шеремета, облегчавшую малому и среднему бизнесу путь к статусу национальной модели, отклонили.
«Справедливая Россия» при третьем чтении воздержалась. Председатель Думы Вячеслав Володин назвал документ рамочным: детали пропишет правительство в подзаконных актах, а Дума пообещала вернуться к основным положениям до конца года.
Закон охватывает только большие модели
Предмет в статье 1 очерчен узко: создание, запуск и применение больших фундаментальных моделей ИИ. Всё остальное остаётся за рамками.
Пункт 2 статьи 3 добавляет признаки. Большая фундаментальная модель это программа для ЭВМ, у которой разом выполняются все условия:
- решает интеллектуальные задачи не хуже человека;
- обучена на составах данных и умеет находить закономерности, выдавать информацию, принимать решения, прогнозировать по целям, которые задал человек;
- служит базой, на которой строят и дорабатывают другое программное обеспечение;
- насчитывает минимум 1 миллиард параметров;
- используется для множества разных задач.
Признаки работают только вместе. Модель на 7 миллиардов параметров, распознающая лишь автомобильные номера, под определение не попадает, потому что задача у неё одна. Универсальной модели на 500 миллионов параметров не хватит размера. Кредитный скоринг и антифрод, компьютерное зрение, классификаторы, сценарные чат-боты остаются вне действия закона. По оценке АНО «Цифровая экономика», таких моделей в стране несколько десятков.
Разработчик по закону это индивидуальный предприниматель или юрлицо, которые такую модель проектируют, обучают либо модифицируют. Всё решает слово «модификация». Компания, дообучившая открытую модель на 8 миллиардов параметров под свои задачи, автоматически становится разработчиком. Правда, обязанности придут только вместе со статусом.
Само понятие искусственного интеллекта в пункте 1 статьи 3 выросло из Национальной стратегии, но с добавкой. Это «комплекс технологических решений, позволяющий имитировать когнитивные функции человека», который на конкретных задачах даёт результат не хуже человеческого или лучше. В скобках закон дописывает умение самостоятельно улучшать свои функции, повышать точность на новых данных и находить решения без заранее заданного алгоритма. Внутри комплекса инфраструктура, программы, процессы и сервисы обработки данных.
Часть 3 статьи 1 выводит под отдельные правила оборону и безопасность, оперативно-разыскную деятельность, охрану порядка и безопасность дорожного движения, борьбу с отмыванием денег и финансированием терроризма, предотвращение чрезвычайных ситуаций, дипломатию и государственное управление. Особенности для этих сфер пропишут другие федеральные законы и акты президента.
Девять принципов, из которых три задают характер закона
В статье 4 перечислены девять принципов. Некоторые из них предсказуемы: благоприятные условия для развития, международное сотрудничество, поддержка российских разработчиков. Отдельно названы права и свободы человека, уважение автономии и свободы воли, безопасность.
Характер документа определяют три принципа.
Технологическая независимость. Модели предполагается создавать при сохранении национального контроля над критическими и сквозными технологиями и с опорой на собственные линии разработки. Задача такой установки: экспорт и вытеснение с внутреннего рынка продукции, сделанной на устаревших либо иностранных технологиях.
Риск-ориентированный подход. Требования к применению моделей привязывают к вероятности и масштабу вреда, который может коснуться жизни и здоровья, деловой репутации, имущества, технологической независимости государства, окружающей среды. Та же логика лежит в основе европейского AI Act. Но классов риска и списка запрещённых применений в российском законе нет. Правительство получает лишь право вводить отраслевые требования.
Традиционные российские духовно-нравственные ценности. Их закон называет поимённо и без сокращений: жизнь, достоинство, права и свободы человека, патриотизм, гражданственность, служение Отечеству и ответственность за его судьбу, высокие нравственные идеалы, крепкая семья, созидательный труд, приоритет духовного над материальным, гуманизм, милосердие, справедливость, коллективизм, взаимопомощь и взаимоуважение, историческая память и преемственность поколений, единство народов России.
Никаких обязанностей из одного этого принципа не вытекает. Зато статья 6 делает его условием статуса, а это одна из самых практичных норм всего документа.
Полномочия разложены между президентом, правительством и Минцифры
Статья 5 разводит полномочия между органами. Национальную стратегию развития ИИ утверждает президент. Правительство сводит работу ведомств, задаёт меры поддержки, решает, когда применение российских моделей обязательно, и может вводить отраслевые требования по рискам. Когда речь о банках и финансовом рынке, оба решения проходят согласование с Банком России.
Минцифры — уполномоченный орган в сфере информационных технологий. Оно анализирует, как развиваются большие модели, предлагает поправки в регулирование, помогает госорганам и муниципалитетам запускать модели в работу, готовит меры стимулирования. Контроля по этому закону у него нет: ни проверок, ни реестра, ни права штрафовать.
Большие модели в важнейших отраслях, социальной сфере и управлении запускают госорганы, муниципалитеты, госкорпорации и Центробанк, каждый в пределах своей компетенции. Под это подогнаны и цели из статьи 2: ускоренное развёртывание, господдержка исследований, технологическая независимость, эффективность управления, конкурентоспособность «на мировом уровне», продвижение российских технологий за рубежом. Про защиту пользователей там тоже сказано, но одной общей формулой о безопасности личности, общества и государства.
Два статуса, которые расходятся в двух пунктах
В статье 6 появляются два статуса. Набор требований к ним почти одинаков, различия всего в двух пунктах.
Суверенная модель проходит по пяти требованиям:
- разработчик — российское юридическое лицо;
- характеристики модели на всех стадиях жизненного цикла определяет и меняет та же компания;
- воспроизводимость цикла разработки, включая обучение, разработчик обеспечивает полностью, в техническом и технологическом смысле;
- запросы пользователей обрабатываются, а данные хранятся в дата-центрах на территории России, и принадлежат эти дата-центры российским юрлицам;
- соответствие законодательству России и традиционным ценностям подтверждено в порядке, который установит правительство.
Национальная модель тоже российская по владельцу, тоже живёт в отечественных дата-центрах и тоже требует подтверждения соответствия закону и ценностям. А вот второй и третий пункты выглядят иначе. Сама компания определяет и меняет лишь существенные характеристики модели, а их список установит правительство: структура, программное обеспечение, настраиваемые параметры. Брать при разработке разрешено компоненты любого происхождения, включая чужие большие модели с открытой лицензией.
Если коротко: суверенную модель обучают с нуля, и одна компания способна воспроизвести её целиком. Национальная вправе опираться на чужой открытый фундамент, лишь бы структура, код и параметры оставались под контролем российского разработчика.
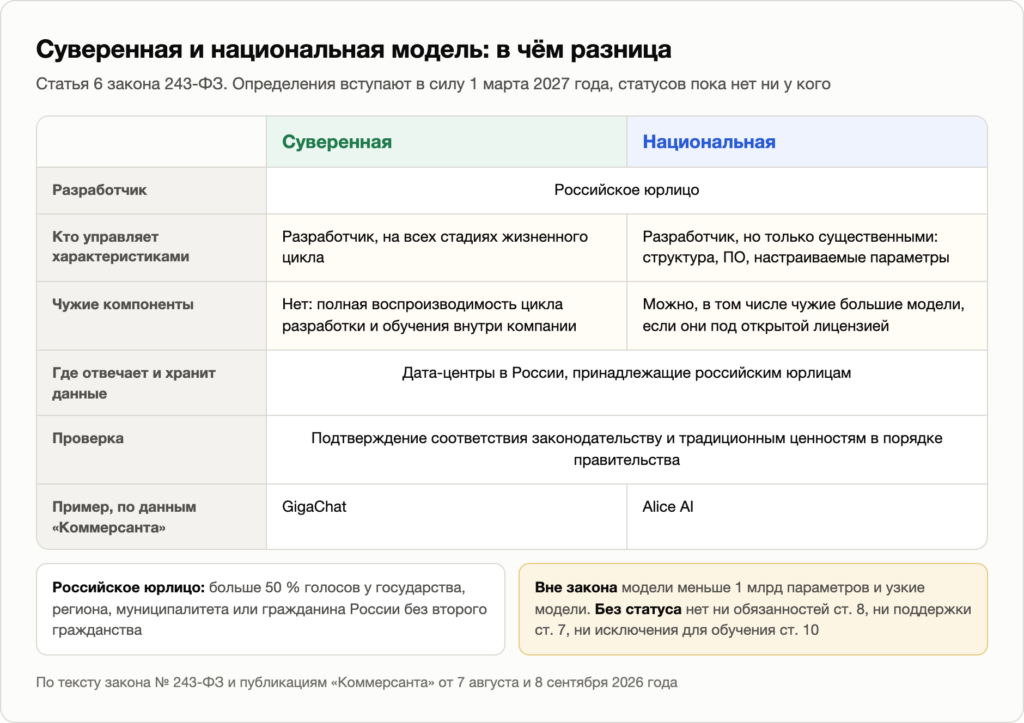
Российское юрлицо в трактовке закона — это компания, которой владеет государство, регион, муниципалитет или гражданин России без второго гражданства, единолично либо в любой комбинации. Под контролем понимается возможность прямо или косвенно распоряжаться более чем 50 % голосов. Международный договор может дать исключение, но без него иностранный мажоритарий закрывает путь к статусу: московская регистрация и серверы в Подмосковье тут не помогут.
Пятый пункт в обоих списках стоит разобрать отдельно. Соответствие «традиционным российским духовно-нравственным ценностям» тоже нужно подтвердить, иначе статуса не видать. Как именно пройдёт проверка, кто её проводит и по каким критериям, в законе не сказано: порядок устанавливает правительство.
Как учитывать модели и присваивать статусы, тоже решает правительство. Статусов на сегодня нет ни одного, и появиться они не могут: определения из частей 2–5 статьи 6 начнут действовать лишь с 1 марта 2027 года.
Официального перечня нет, но оценки уже появились
Официального списка не существует. 8 сентября «Коммерсантъ» со ссылкой на участников рабочей группы сообщал: под суверенное определение сейчас попадает одна модель, GigaChat Сбера. Alice AI «Яндекса» там же названа примером национальной модели.
7 августа газета разобрала критерии для национальной модели из ещё не принятого проекта постановления. Разработчику нужны исключительные права:
- на обучаемые параметры и архитектуру, в том числе конфигурационные файлы и топологию сети;
- на исходники обучения и эксплуатации модели;
- на конфигурацию контекстного окна.
Всё прочее может быть иностранным, открытым или чужим. Тимофей Воронин, руководитель проектов по аналитике ИИ, оценил, что такие условия отсекут примерно 90 % российских ИИ-стартапов и компаний. Большинство работает на открытом коде, поэтому претендовать на статус по силам только крупным экосистемам. Владимир Нелюб, директор по науке и ИИ «Группы Астра», видит в статусе прежде всего путь к государственным данным и крупным госконтрактам. Обязательным атрибутом рынка он его не считает. А в АНО «Цифровая экономика» добавляют: для малых языковых моделей статусов не предусмотрено вовсе.
В спорах о статусах всплывает и цена. Сервис AIANA, на который ссылается «Коммерсантъ», даёт такие цифры: тысяча токенов GigaChat Max обходится в 0,65 рубля, YandexGPT Pro 5.1 в 0,8 рубля, открытые модели примерно в 0,2–0,3 рубля. Сергей Кобелев из «Яков и партнёры» в том же материале обратил внимание на другое: главные расходы не в токенах, а в запуске в работу, человеческой проверке результата и доработках.
Статус даёт разработчику пять прав, но конкретных мер в законе нет
В статье 7 перечислено, что получает разработчик модели со статусом суверенной или национальной. Пунктов пять:
- государственная поддержка, на которую он вправе рассчитывать;
- право обучать модель на произведениях других авторов по правилам статьи 10;
- работа в отраслевых объединениях, участие в этических правилах и в подготовке предложений для госполитики в сфере ИИ;
- сотрудничество с зарубежными коллегами, совместные исследования и экспорт своих технологий;
- страхование имущества и ответственности за вред, который модель может причинить при применении.
Что стоит за первой строкой, статья не раскрывает: речь идёт только о доступе к мерам. Сами меры называет правительство, и полномочия у него по статье 5 записаны широко:
- финансовая поддержка;
- поддержка имуществом;
- гарантии;
- информационная поддержка.
Дороже денег может оказаться другой ресурс, и это данные. Как обучать суверенные и национальные модели на данных из федеральных информационных систем, из систем федеральных унитарных предприятий и учреждений, определит правительство. Порядок доступа оно согласует с ФСБ.
У регионов право такое же, но для своих систем и подконтрольных организаций. Григоренко 24 сентября отнёс доступ к данным, включая государственные, к вопросам, вокруг которых строятся подзаконные акты.
Статья 12 добавляет ещё одно правило: российским гражданам и компаниям нельзя мешать сотрудничать с зарубежными партнёрами в области больших моделей. Запрет не действует только для отдельных значимых направлений, перечень которых определит правительство.
Со сроками у статьи 7 вышла странность. В силу она вступила 1 сентября 2026 года, а определения суверенной и национальной модели появятся лишь 1 марта 2027-го. Выходит, полгода права обладателя статуса уже работают, а самих обладателей статуса нет.
У обладателя статуса три обязанности, и включаются они в 2027 году
Статья 8 короткая. Обязанностей у разработчика суверенной или национальной модели три:
- организационные и технические меры, которые обеспечивают безопасность модели;
- описанные правила эксплуатации: какие есть ограничения и условия применения, как модель обновляют и как снимают с эксплуатации;
- техническая документация, где основные параметры и ограничения расписаны настолько подробно, чтобы можно было оценить безопасность применения.
Действуют эти обязанности с 1 марта 2027 года, и только для тех, у кого есть статус. Если статуса нет, закон ничего не требует, и неважно, российский это разработчик или иностранный. Логика документа понятна: требования прилагаются к статусу, то есть к участию в господдержке. Общих правил для всего рынка они не создают.
Маркировка осталась правом автора, а площадкам добавили кнопку
Больше всего путаницы вызвала статья 9. Разбирать её удобнее по частям.
Часть 1. Тот, кто делает аудио- или визуальный материал с помощью большой модели, получает «возможность размещения информационного предупреждения о применении технологий искусственного интеллекта». Это право, а не обязанность. Тексты в этой части не упомянуты.
Часть 2. Как выглядит предупреждение, что в нём написано и где его размещать, договариваются двое: пользователь модели и тот, кто открывает ему доступ. На практике это пользовательское соглашение сервиса.
Часть 3. Здесь появляется единственная обязанность. Сайт, отдельная страница, информационная система или программа должны дать пользователям возможность поставить предупреждение о применении больших моделей. Но только если ресурс совпадает сразу по четырём признакам:
- он нужен, чтобы распространять информацию через личные страницы самих пользователей;
- он ведётся на русском, ещё на государственных языках республик либо на иных языках народов России;
- он способен показывать рекламу, которая адресована потребителям в России;
- в сутки его открывают более 500 тысяч человек из России.
Все четыре признака должны сойтись одновременно. Если хотя бы один не выполняется, кнопка не нужна.
Признаки те же, что у реестра соцсетей: личные страницы, реклама и порог в 500 тысяч человек в сутки. По статье 10.6 закона об информации Роскомнадзор ведёт такой реестр с 2021 года. В списке есть ВКонтакте, Одноклассники, YouTube, Telegram и ряд других сервисов. Самого реестра в тексте закона не упомянуто, поэтому точный круг площадок покажет практика.
Дальше стоит заметить расхождение между частями. Первая говорит об аудио и визуальных материалах. Третья сформулирована шире: «информация, созданная с применением больших фундаментальных моделей искусственного интеллекта».
Если читать буквально, площадка обязана дать возможность пометить и текстовый пост. Как это прочитают проверяющие, станет ясно не раньше марта.
Ответственности за отсутствие кнопки в законе нет: новой статьи в КоАП не появилось. Сила у статьи 9 появится 1 марта 2027 года.
Обязательную маркировку Дума уже один раз отклонила
Идея обязательной метки уже доходила до Думы. В законопроекте № 1069302-8, который внесли Дмитрий Гусев, Алексей Журавлёв и Михаил Делягин, предлагалось ставить на сгенерированное видео надпись «Сделано ИИ». Профильный комитет 24 апреля рекомендовал проект отклонить. 10 июня 2026 года Дума с комитетом согласилась.
Антон Горелкин говорил тогда, что меру трудно реализовать: авторы не решили, где именно появляется метка и с кого спрашивать за ошибку в ней.
Практические вопросы с тех пор не исчезли. Кто ставит метку, если ролик сделал один человек, а выложил другой? Переживёт ли метка перезагрузку файла на другую площадку? Кто её проверяет?
Алексей Шпильман из «Т-Технологий» назвал главным не создание метки, а её живучесть. Видимую надпись ничего не стоит обрезать, а водяной знак, которого не видно, снимет уже другая модель.
Законопроект № 1317978-8 переносит метку на сервис, а не на автора
Поправку в уже принятый закон внесли 17 августа 2026 года четыре депутата от КПРФ: Нина Останина, Сергей Обухов, Алексей Корниенко и Михаил Матвеев. По их замыслу статью 9 надо заменить целиком, а не править по частям.
В силу поправка должна вступить 1 марта 2027 года, вместе с исходной статьёй. Долг переносится на сервис, который открывает доступ к модели. Ни автор, ни площадка за метку больше не отвечают. Ограничений по аудио и видео проект не содержит, так что формально метить пришлось бы и текст.
Новая редакция убирает и право пользователя на предупреждение, и обязанности площадок. Наказания за нарушение проект не предусматривает. Зарубежный опыт авторы упоминают в пояснительной записке.
В Китае двухуровневая маркировка, видимая и скрытая в метаданных, действует с 1 сентября 2025 года. Индия с 20 февраля 2026 года требует от платформ видимой метки на сгенерированных материалах и сохранения источника в метаданных. В Европе машиночитаемую маркировку требует AI Act.
Новый комитет по цифровому развитию и искусственному интеллекту получил законопроект 12 октября, туда его направил Совет Думы. Отзывы собирают до 11 ноября, а рассмотрение стоит в примерной программе на ноябрь.
Авторское право: обучение без согласия
Статья 10 состоит из двух частей, обе вступают в силу 1 марта 2027 года.
Часть 1 касается всех сервисов, а не одних лишь обладателей статуса. Любой, кто предоставляет доступ к большой модели, обязан уведомить пользователя, если иное не предусмотрено законодательством:
- кому принадлежат права на результаты, полученные с помощью модели;
- на каких условиях пользователь получает к ним доступ, может их использовать и сохранять, если это технически возможно.
На практике это пункт в пользовательском соглашении сервиса. Формально норма касается и иностранных сервисов, доступных в России, хотя как её будут применять к ним, закон не говорит.
Часть 2 вводит исключение из авторского права. Не нарушает авторские и смежные права обращение к информации из произведений, включая компьютерное извлечение, сравнение, классификацию и анализ закономерностей, тенденций и корреляций, а также краткосрочную запись в память компьютера. Условия такие:
- единственной целью названо обучение модели, суверенной либо национальной;
- экземпляр произведения разработчик получил на законных основаниях, либо произведение обнародовано и его можно анализировать, не обходя технические средства.
Выходит, что правообладатель может запретить обучение только технически: закрыть текст пейволлом, логином или иной защитой. Письменного запрета на сайте мало. Закон молчит и о том, признают ли техническим средством запись в robots.txt либо машиночитаемую оговорку, подобную европейскому режиму анализа текстов и данных. Права на вознаграждение тоже нет.
Действует такая льгота лишь для моделей суверенных и национальных. Все прочие разработчики подчиняются общим нормам Гражданского кодекса, где подобного изъятия не предусмотрено.
Конфликт с Гражданским кодексом
Пункт 5 статьи 1229 ГК гласит, что ограничения исключительных прав устанавливаются самим кодексом. Норма об обучении появилась в отдельном законе. На это расхождение обратила внимание Лидия Михеева, заместитель председателя Совета по кодификации.
Правообладатели до второго чтения добивались, чтобы обучение было платным или требовало согласия. Итоговый текст этого не предусматривает. Дальше события шли так:
- в конце июля президент, по сведениям «Ведомостей», дал поручение готовить поправки, регулирующие отношения правообладателей и разработчиков нейросетей;
- Совет по кодификации собрал рабочую группу, которая займётся правкой части четвёртой ГК; её наработки ожидались к концу сентября. Сопредседатель совета Павел Крашенинников сформулировал так: «Нужен баланс, мы попробуем его выстроить»;
- 5 августа у правительства появилась отдельная структура по ИИ и авторскому праву, ориентированная на медиасферу и творческие профессии;
- обсуждали варианты вроде прямого лицензирования, коллективного управления правами и сборов по модели «налога на болванки», который в авторском праве исчисляется как 1 % цены техники и носителей. Такую аналогию привёл Игорь Дроздов, зампред ВЭБ.РФ.
На 17 октября текста поправок в открытом доступе я не нашёл. Дмитрий Шатунов, депутат нового думского комитета по ИИ, среди тем для доработки закона назвал и авторское право.
Ответственность: новых штрафов нет
Статья 11 умещается в одно предложение: участники отношений, нарушившие закон или подзаконные акты, отвечают по российскому законодательству. Свежих составов ни в КоАП, ни в УК закон не добавляет.
Безнаказанным применение ИИ от этого не становится. Мошенничество с клонированным голосом остаётся мошенничеством, клевета с поддельным видео остаётся клеветой, а когда персональные данные утекают через чат-бота, работают статьи о персональных данных. Закон просто не добавляет к этим составам ничего своего.
Дипфейки как отягчающее обстоятельство
Законопроект № 1288702-8 внесли 14 июля 2026 года: двое сенаторов и депутаты фракции ЛДПР, которых возглавляет Леонид Слуцкий. Документ добавляет в часть 1 статьи 63 УК пункт «х»:
преступление, совершённое с применением видеозаписи, аудиозаписи, изображения (включая электронное) либо других аудиовизуальных материалов, которые созданы технологиями искусственного интеллекта или иными техническими средствами обработки информации, когда такие материалы передают или имитируют высказывания либо действия лица, которых оно в действительности не совершало, или показывают человека, чья личность сгенерирована технологиями.
Предполагалось, что поправка заработает с 1 сентября 2026 года. Дата прошла, но решение по законопроекту комитет по государственному строительству и законодательству до сих пор не вынес.
К законопроекту приложены два официальных отзыва, оба с критикой. Отзыв Верховного суда датирован 19 марта 2026 года, подпись под ним поставил заместитель председателя суда Н. В. Тимошин; в документе сказано, что по тому самому поручению № Пр-706 суд изучил практику и опросил судей. Выводы:
- суды отметили лишь единичные дела, где для преступления использовались технологии, которые можно отнести к ИИ;
- признак уместнее сделать квалифицирующим или составообразующим в конкретных статьях, например о мошенничестве, а не общим отягчающим обстоятельством;
- сама формулировка не проводит границы между правомерным и неправомерным использованием и «может повлечь необоснованное расширение уголовно-правовой репрессии».
Ответ правительства датирован 14 апреля 2026 года и краток. Схожие инициативы кабинет уже оценивал: отзывы датированы 22 июля 2024 года и 22 августа 2025 года, и содержащиеся в них замечания не утратили силы — позиция остаётся неизменной.
Что на самом деле говорят цифры
В пересказах законопроекта гуляет цифра 675,4 тысячи: столько якобы «преступлений с использованием дипфейков» зафиксировали в 2025 году. Пояснительная записка говорит иное. МВД относит эти 675,4 тысячи ко всем преступлениям, что совершены с применением информационно-телекоммуникационных технологий либо в сфере компьютерной информации; это 38,1 % от всех зарегистрированных. Мошенничество даёт 348 тысяч, незаконный оборот наркотиков 138,7 тысячи, кражи 81 тысячу.
Про дипфейки в той же записке другие цифры. За девять месяцев 2025 года, по сведениям АНО «Диалог Регионы», в рунете выявили 342 уникальных дипфейка против 84 за весь 2024 год. Копий набралось около 55 тысяч, суммарный охват превысил 122,5 миллиона просмотров. Компания VisionLabs, по данным «Известий» от 16 октября, за 2025 год зафиксировала 627 дипфейков, а к сентябрю 2026-го около 900. Методики у источников разные, однако рост виден в любой из них. И всё же счёт идёт на сотни уникальных подделок, а не на сотни тысяч преступлений.
Что уже запрещено
Одно ограничение по ИИ вступило в силу давно, причём прописано оно не в 243-ФЗ. Соответствующий закон подписали 2 мая 2026 года, а Дума одобрила его 21 апреля, документ проходил как законопроект № 1155581-8. В предвыборной агитации запрещены образы вымышленных и умерших людей, равно как изображения и голоса, которые созданы информационными технологиями. Не касается запрет лишь самого кандидата и выдвинувшей его партии, а ещё тех, кто достиг совершеннолетия и оформил письменное согласие по форме ЦИК.
С 1 марта 2027 года заработают пять блоков норм
Статья 13 сдвигает срок на 1 марта 2027 года. С этой даты начнут действовать пять вещей.
- кабинет министров получит право называть случаи, когда разрешены только суверенные или национальные модели;
- та же возможность вводить отраслевые требования, которые снижают риски;
- правила доступа к государственным данным для обучения;
- трактовка суверенной и национальной модели, определение российского юрлица и порядок выдачи статусов;
- обязанности разработчиков, маркировка и нормы об авторском праве.
Дату взяли не наугад. В законе № 247-ФЗ об обязательных требованиях есть общее правило: новые обязательные требования начинают действовать 1 марта или 1 сентября, но не раньше чем через 90 дней после публикации. Значит, чтобы нормы из постановлений включились 1 марта 2027 года, сами постановления должны выйти примерно до начала декабря. Не успеют выпустить, и следующая дата будет только 1 сентября 2027 года.
Перечень сфер с обязательными российскими моделями ещё не закрыт
Сильнее всего ждут постановление, которое назовёт случаи, где работать позволят исключительно суверенным или национальным моделям. Для банков и финансового рынка эти случаи согласуют с Банком России.
По сведениям «Коммерсанта» от 8 сентября, в рабочей версии перечня восемь направлений:
- критическая информационная инфраструктура;
- стратегическое планирование;
- госпрограммы и нацпроекты;
- подготовка нормативных актов в госорганах;
- налоги, таможня и бюджетная сфера;
- образование;
- здравоохранение;
- государственные услуги.
Раньше в обсуждении звучали ещё безопасность, выборы и государственное управление. Спорнее всего правило из той же рабочей версии. Компанию обяжут взять суверенную модель, если она дороже сравнимой национальной не больше чем в полтора раза. Источник издания говорил, что предложение шло от Сбера, владельца единственной модели, которая сейчас подходит под суверенную. В Сбере это опровергают и называют перечень набором идей всех участников рабочей группы.
Как высказались участники:
- Минцифры обсуждение подтвердило, но считает разговор о готовом перечне преждевременным;
- «Яндекс» за конкуренцию и за право отраслей самим выбирать технологические решения;
- MWS AI предупредила: для части задач в критических отраслях может не хватить моделей, подходящих по качеству и по экономике;
- Антон Сипачёв из Just AI заметил, что на прикладных задачах компактные модели вроде GigaChat Lightning или YandexGPT Lite дают качество того же уровня, но дешевле, а главным выгодоприобретателем правила назвал одну компанию.
Системы, которые уже работают, получили отсрочку до 2032 года
Третья часть статьи 13 прикрывает системы, запущенные раньше. Запрет работать только на российских моделях до 1 сентября 2032 года на них не распространяется. Речь об информационных системах, которые создали или использовали на день вступления нормы в силу, то есть 1 марта 2027 года. Условие одно: обработка и хранение данных должны идти в России.
Что это даёт на практике. Система из будущего перечня обращается к зарубежной модели по API, значит данные уходят за рубеж и под переходный период она не подпадает. Если модель развёрнута на своих серверах в России, у владельца есть ещё пять с половиной лет.
Четвёртая часть той же статьи разрешает особенности применения статей 3 и 6 в экспериментальных правовых режимах, если их согласовать с Минцифры. В пилотном проекте программа режима может смягчить требования к статусу или само определение большой модели.
Голосового помощника хотят заменить системным
Ещё один проект Минцифры правит постановление № 1867, то есть порядок обязательной предустановки программ на устройства. Категорию «голосовой помощник» предлагают заменить на «системный помощник». Это ИИ-программа, которая работает с устройством, операционной системой и приложениями через голос, текст и изображения. Предустанавливать придётся программу с моделью, у которой есть статус национальной или суверенной.
По данным «Коммерсанта», помощнику хотели прописать запрет на удаление, который сейчас действует только у магазина приложений, и выдать «все специальные разрешения». Среди них фоновое обновление, фоновые службы push-уведомлений и голосовая активация. Прежде всего речь об «Алисе AI». Её недельная аудитория в сентябре, по данным «Яндекса», дошла до 41 миллиона человек.
В «Яндексе» утверждают, что неудаляемости в тексте проекта нет, а есть пункт о возможности отключить помощника. Компания выступает за равные условия для российских и иностранных сервисов. Минцифры говорит, что пользоваться помощником человек должен добровольно.
Ассоциация РАТЭК просит приостановить проект до оценки регулирующего воздействия и отложить вступление в силу минимум на пять месяцев. По мнению ассоциации, сквозной доступ помощника к системе спорит с правом пользователя такой доступ запретить. А обновлять приложение в фоне без разрешения на закрытых сертифицированных ОС невозможно технически. Проект пока на доработке.
Правительство обещает подзаконные акты, но сроки сдвигаются
В августе аппарат вице-премьера обещал принять подзаконные акты «уже осенью». 24 сентября Григоренко сказал, что документы готовят в развитие принятого закона, а о втором пакете мер речь пока не идёт. Внедрять закон, по его словам, будут несколько лет. Проблемы станут решать по мере появления практики, а цель не в том, чтобы регулировать ради самого регулирования.
Финальных текстов постановлений к 17 октября я не нашёл. Обсуждение идёт в восьми рабочих группах правительственной комиссии по развитию ИИ и на площадке АНО «Цифровая экономика».
В Думе появился отдельный комитет по ИИ
Дума девятого созыва, избранная в сентябре, создала комитет по цифровому развитию и искусственному интеллекту. Возглавил его Александр Сидякин, первым заместителем стал Антон Немкин. Оба они из «Единой России». Кроме ИИ комитет занимается маркетплейсами, беспилотниками и креативной экономикой.
Закон об ИИ раньше проходил через комитет по информационной политике. Теперь новые законопроекты об ИИ уходят в новый комитет. Первой туда направили поправку КПРФ о маркировке.
Что в закон не вошло
Понять короткий документ легче всего по тем пунктам, которых в нём нет. Рядом с мартовской редакцией эти пустоты видны особенно ясно.
- Реестра моделей. Порядок учёта и правила присвоения статусов правительство пропишет. Обязательной регистрации крупных моделей при этом не вводится.
- Классов риска и запрещённых практик. Риск-ориентированный подход записан как принцип. Механизма под него не придумали.
- Обязанностей для моделей без статуса. Зарубежный сервис и отечественная модель без статуса по этому документу почти ничего не обязаны. Исключение одно: сообщить пользователю, у кого права на результат.
- Распределения ответственности между тем, кто модель создал, кто её обслуживает и кто ею пользуется. В мартовском проекте такая схема была.
- Ответа на вопрос об авторе сгенерированного. Закон даёт только требование сообщить пользователю, кому принадлежат права. Сам вопрос решает Гражданский кодекс: статья 1228 называет автором гражданина, который создал результат собственным творческим трудом. Картинка, целиком нарисованная моделью по короткому запросу, в эту формулу укладывается с трудом.
- Правил для отдельных отраслей. Медицина, образование и финансы получат свои требования лишь в том случае, если правительство воспользуется правом их ввести.
- Запрета иностранных моделей. Ограничения возможны не раньше 1 марта 2027 года и только в тех сферах, которые определит правительство.
Как этот подход смотрится рядом с ЕС и Китаем
Логика российского документа отличается от европейской и китайской. Сравнение помогает её увидеть.
Европейский союз. AI Act делит системы ИИ по уровню риска от применения: практики под запретом, высокий риск, ограниченный, минимальный. Обязанности прозрачности из статьи 50, включая машиночитаемую маркировку синтетического контента, действуют с 2 августа 2026 года. За нарушение штрафуют на сумму до 15 миллионов евро или 3 % мирового оборота. Для систем высокого риска сроки сдвигает пакет поправок Digital Omnibus, теперь это конец 2027 года.
Китай. Меры по идентификации сгенерированного контента работают там с 1 сентября 2025 года. Метка ставится на двух уровнях: одна видна человеку, вторая спрятана в метаданных файла. Правило охватывает текст, изображения, аудио и видео. Платформы обязаны проверять метки, а стирать их или подделывать нельзя.
Индия и Южная Корея. С 20 февраля 2026 года Индия требует от платформ видимую метку на сгенерированном аудио и видео, где имитируются реальные люди, и записи источника в метаданные, которую удалить нельзя. В Южной Корее маркировка сгенерированного контента действует с января 2026 года.
Россия. Здесь регулируют не применение, а сами модели, и деление идёт не по риску, а по размеру и происхождению. Маркировать контент автор вправе, но не обязан, санкций нет. Наполняют документ статусы, господдержка, доступ к данным и обещанные требования брать отечественные модели в госсекторе. По сути это закон о промышленной политике в сфере ИИ, а не о безопасности пользователей.
Что это даёт на практике
Если вы пользуетесь нейросетями. Пока для вас не меняется ничего. Зарубежные модели закон не запрещает и помечать сгенерированное не заставляет. С 1 марта 2027 года сервисы будут обязаны прямо написать, у кого права на результат, а крупные соцсети дадут возможность отметить пост как созданный с помощью ИИ.
Если вы ведёте блог или канал. Сгенерированные картинки и ролики помечать не обязательно, пока не принята поправка КПРФ. Правила самих площадок нередко жёстче закона, читайте их отдельно. А в предвыборной агитации сгенерированные лица и голоса под запретом уже сейчас.
Если ваша компания внедряет ИИ. За пределами госсектора, критической инфраструктуры, образования и здравоохранения документ вас почти не затрагивает. Тем, кто работает в этих сферах или на госзаказе, стоит следить за постановлением о случаях обязательного применения. Системы, которые к 1 марта 2027 года уже работают на модели, развёрнутой в России, защищены до сентября 2032 года. Системам на иностранном API такой защиты не будет.
Если вы разрабатываете модели. Под закон не попадает модель меньше миллиарда параметров или узкоспециализированная. Дообучив открытую модель, вы формально становитесь разработчиком, однако обязанности придут только вместе со статусом. Статус национальной модели дают, если вам принадлежат архитектура, параметры и код, а чужие компоненты распространяются по открытой лицензии. Взамен вы получаете господдержку, доступ к государственным данным и право обучаться на чужих произведениях без согласия авторов.
Если вы правообладатель. Начиная с 1 марта 2027 года разработчики моделей со статусом смогут обучаться на ваших открытых текстах, изображениях и музыке. Защититься получится только техническими средствами. Поправки в Гражданский кодекс готовятся, их текста пока нет.
Что успеть сделать до 1 марта 2027 года
- Владельцу крупной площадки с персональными страницами: заложить в продукт механизм, который позволит пометить публикацию как созданную с помощью ИИ. И речь не только о картинках и видео: часть 3 статьи 9 говорит об информации вообще.
- Сервису, который даёт доступ к большой модели, в том числе через чужой API: добавить в условия использования пункт о том, у кого права на результат и как пользователь может его применять и сохранять. По буквальному смыслу части 1 статьи 10 это касается всех, кто предоставляет возможность применения модели.
- Компании в госсекторе, критической инфраструктуре, образовании или здравоохранении: составить перечень систем с большими моделями и выяснить, где обрабатываются данные. От этого зависит, попадёт ли система в переходный период до 2032 года.
- Разработчику модели, который рассчитывает на статус: проверить структуру собственности и порог в 50 %, права на параметры, архитектуру и код, лицензии на чужие компоненты и то, размещён ли инференс в российских дата-центрах.
- Всем остальным: следить за regulation.gov.ru. Постановления, которым предстоит заработать 1 марта, по общему правилу появятся там до декабря.
Где искать первоисточники
- Текст закона. Федеральный закон от 26.07.2026 № 243-ФЗ; официальный портал правовой информации pravo.gov.ru; Собрание законодательства РФ, 2026, № 30, ст. 4089.
- Карточка законопроекта № 1271570-8 в системе sozd.duma.gov.ru: даты, тексты к каждому чтению, таблицы поправок.
- Законопроекты № 1317978-8 о маркировке и № 1288702-8 о дипфейках лежат там же, вместе с пояснительными записками и официальными отзывами.
- Проекты постановлений выкладывают на regulation.gov.ru. Финальных редакций на дату статьи там нет.
Первый отечественный закон об ИИ вышел осторожным и коротким. До марта 2027 года он почти никого не обязывает и почти ничего не запрещает, а вопрос о том, где разрешат только отечественные модели, передан правительству. Значит, реальное регулирование стартует не с текста закона, а с постановлений, которые должны появиться до декабря. Читать их придётся внимательнее, чем сам закон.
Полная версия: http://bigpanda.mirtesen.ru/blog/43510463046/Zakon-ob-II-v-Rossii-chto-deystvUyet-s-1-sentyabrya-2026-goda-i-

Комментарии