

Нейросеть хорошо читает отзывы и плохо их считает: протокол анализа отзывов для маркетинга и продукта
Языковая модель честно экономит часы на разметке отзывов и интервью, но искажает именно то, ради чего её зовут: какие проблемы главные и насколько они велики. Разбираю, где проходит граница, и даю пошаговый протокол, который держит модель в рамках. Он пригодится всем, кто работает с голосом клиента: маркетологу, специалисту по репутации бренда, продукту.
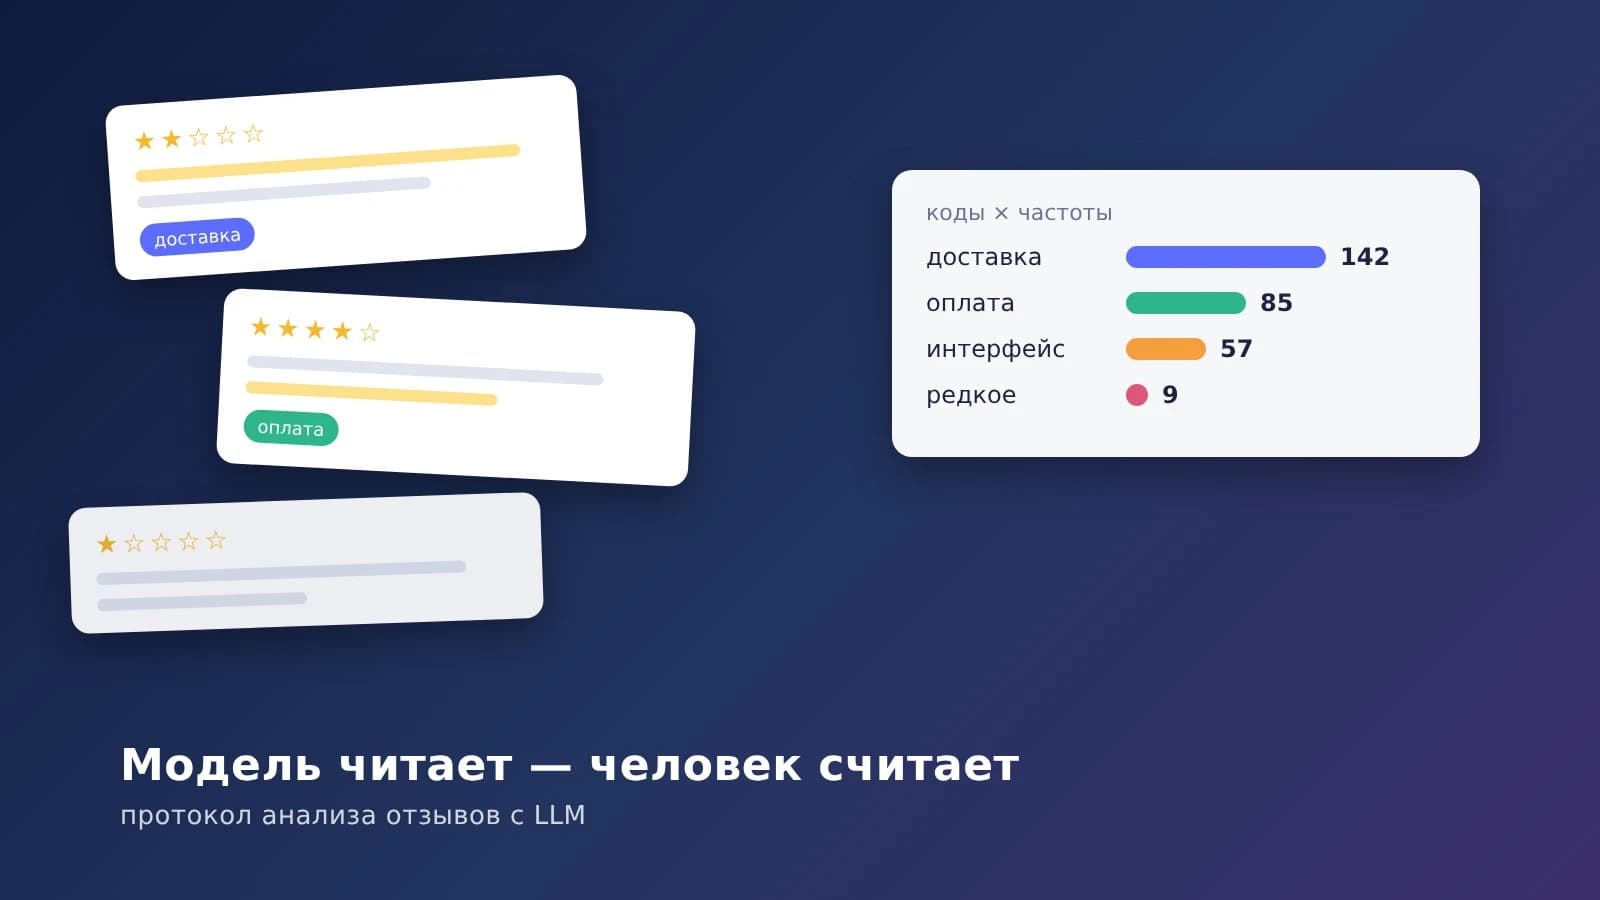
Сценарий знаком почти каждому, кто разбирает обратную связь клиентов. Выгружаешь три тысячи отзывов из App Store и Google Play, вставляешь в чат и пишешь: «Выдели основные проблемы пользователей». Через минуту получаешь аккуратный список из семи тем, у каждой пометка «часто упоминают» или «многие пользователи». Выглядит как исследование, и его хочется отправить в канал команды.
Мой тезис: в такой схеме модель делает хорошо то, что нам не очень нужно, и плохо то, ради чего её позвали. Она отлично разбирает отдельный отзыв на смысловые куски, находит цитаты, переводит смешанный язык. Но вопросы «что главное» и «сколько их» она решает на глаз, и этот глаз систематически ошибается. Поэтому рабочая схема простая по сути: модель читает и размечает, а считает и решает человек с таблицей.
Где экономия настоящая
Хороший ориентир даёт Apple. В апреле 2025 года команда машинного обучения компании описала, как устроены AI-сводки отзывов в App Store. Там нет одного запроса «суммаризируй». Сначала отзывы фильтруются от спама, брани и мошенничества. Затем отдельная дообученная модель разбивает каждый отзыв на короткие «инсайты»: каждый из них атомарное утверждение об одном конкретном аспекте. Вторая модель даёт инсайтам названия тем, после чего дубликаты объединяются. Темы отбираются в первую очередь по популярности, а тональность отобранного сверяется с общим рейтингом приложения, чтобы сводка не уехала в негатив или позитив. Только потом третья модель пишет текст, а люди-асессоры оценивают его по нескольким критериям, в том числе по тому, насколько он опирается на исходные отзывы.
Отсюда первый вывод: самая полезная работа для LLM в discovery находится на уровне отдельной единицы текста. Разбить условный отзыв «курьер опоздал, но приложение удобное, верните старую кнопку повтора» на три утверждения с тональностью модель умеет быстро и прилично. Ручная разметка на этом шаге съедает больше всего времени.
Второй участок экономии — первичное кодирование по кодбуку. Исследователи Dai, Xiong и Ku (Findings of EMNLP 2023) проверили схему, где человек и GPT-3.5 вместе собирают кодбук для тематического анализа, а потом модель кодирует данные. На двух наборах опросных ответов качество кодирования вышло сопоставимым с людьми-кодировщиками. Важная деталь: кодбук строили в связке с человеком, модель не придумывала категории в одиночку.
Третий участок — поиск цитат и работа с языком. Для рынков, где пользователи пишут на смеси русского и узбекского, да ещё латиницей и кириллицей вперемешку, модель снимает целый слой рутины. Но именно на таком тексте её нужно проверять строже всего: в отзыве на двух языках и двух алфавитах неточный перевод легко принять за смысл, и выборочная сверка из протокола ниже здесь нужна в первую очередь.
Четыре способа, которыми модель искажает картину
Придуманные паттерны. Модель стремится выдать стройную структуру, и если данных на тему мало, она всё равно её сформулирует, причём убедительно. В бенчмарке Summary of a Haystack (Laban и соавторы, Salesforce, EMNLP 2024) модели должны были найти повторяющиеся инсайты в большом массиве документов и сослаться на источники. GPT-4o и Claude 3 Opus без поискового слоя набрали меньше 20% по совокупной метрике, а люди — около 56%. Это синтетическая задача, а не отзывы, и модели с тех пор подросли. Но направление ошибки сохраняется: длинный массив плюс просьба «найди главное» дают текст, у которого часть утверждений не опирается ни на что конкретное.
Искажение частот. «Многие пользователи» — не измерение. Модель не считает отзывы, она взвешивает их по тому, насколько ярко они написаны и где лежат во входных данных. Liu и соавторы в работе «Lost in the Middle» (TACL, 2024) показали, что модели хуже используют информацию из середины длинного контекста, чем из начала и конца. Для продакта это значит буквально следующее: порядок строк в выгрузке влияет на то, какая проблема окажется в топе.
Потеря сигналов меньшинства. Zhang и соавторы (NAACL 2024) проверили девять LLM на шести наборах пользовательских текстов из соцсетей, отзывов и расшифровок и обнаружили, что сводки плохо представляют разные точки зрения. Неприятная деталь: человеческие эталонные сводки тоже оказались несправедливыми. В продукте редкий сигнал часто и есть самый ценный. Жалобы пользователей со старыми Android-устройствами, людей с нарушением зрения, тех, кто платит наличными, будут растворены в «прочих замечаниях».
Угодливость промпту. Если написать «проверь, раздражает ли пользователей долгая доставка», модель с высокой вероятностью найдёт подтверждение. Sharma и соавторы (Anthropic, 2023) показали, что пять популярных ассистентов систематически подстраиваются под взгляды пользователя, и связали это с тем, как модели учат на человеческих предпочтениях. Гипотеза, вписанная в запрос, работает как наводящий вопрос свидетелю.
Протокол: девять шагов
Сформулируйте исследовательский вопрос до загрузки данных и запишите его нейтрально. Не «почему пользователям не нравится новый чекаут», а «что пользователи пишут о процессе оформления заказа».
Подготовьте выборку: уберите дубли и спам, сохраните у каждого отзыва ID, дату, рейтинг, платформу и версию приложения. Перемешайте порядок строк.
Подавайте данные небольшими пачками и просите разбить каждый отзыв на атомарные утверждения. Формат вывода — таблица: ID отзыва, утверждение, дословная цитата, тональность.
Соберите кодбук на 10–15% выборки. Модель предлагает коды, вы правите формулировки, объединяете похожие и записываете определение каждого кода с примером. Обязательно добавьте код «не подходит ни под один».
Закодируйте всю выборку по фиксированному кодбуку. Каждому утверждению — код и цитата. Модели запрещено придумывать новые коды на этом шаге: всё непонятное идёт в «не подходит».
Считайте частоты кодом, а не моделью. Таблица или pandas, группировка по коду, версии и рейтингу. Слова «часто» и «многие» в итоговом документе появляются только рядом с числом.
Сделайте отдельный проход по редкому. Выведите все коды с малым числом упоминаний и всю категорию «не подходит», прочитайте это руками. Здесь лежат сигналы меньшинства.
Проверьте угодливость. Прогоните ключевой вопрос дважды: с вашей гипотезой в промпте и с противоположной. Если выводы меняются вслед за формулировкой, им нельзя доверять.
Сверьте случайную выборку. Возьмите 30–50 случайных утверждений и проверьте, что цитата дословно есть в исходнике, а код поставлен верно. Цитаты удобно проверять простым поиском подстроки в исходном файле.
С интервью логика та же, но риск другой. Интервью мало, и каждое длинное. Модель склонна сглаживать противоречия внутри одного разговора: человек в начале говорит «цена не важна», а через двадцать минут подробно рассказывает, как ушёл к конкуренту из-за сбора за доставку. Поэтому сначала делайте сводку по каждому интервью отдельно, с цитатами и тайм-кодами, и только потом синтез по всем. Синтез из сводок сводок превращается в пересказ пересказа.
Как сравнить человека и модель за два вечера
Собственное маленькое сравнение убеждает команду лучше любой статьи. Вот схема, которую можно повторить на публичных отзывах любого приложения.
Возьмите 200–300 свежих отзывов, разбейте их на утверждения (это можно поручить модели) и отберите случайные 100 утверждений. Два человека независимо кодируют их по одному кодбуку. Модель кодирует те же 100. Дальше считаете три вещи. Первая: согласие между людьми и между человеком и моделью: процент совпадений и каппа Коэна, которая учитывает случайные совпадения. Если люди между собой согласны слабо, проблема в кодбуке, а не в модели. Вторая: топ-5 тем по частоте у людей и у модели, совпадают ли они и в каком порядке. Третья: расхождения: темы, которые нашла только модель (кандидаты в придуманные), и темы, которые нашли только люди (кандидаты в потерянные).
Ниже пример расчёта на условных цифрах, чтобы было видно, как читать результат. Допустим, два кодировщика совпали в 80 утверждениях из 100, а при таком распределении кодов случайное совпадение ожидается в 20% случаев. Тогда каппа равна (0,80 − 0,20) / (1 − 0,20) = 0,75, и кодбуку можно доверять. Допустим дальше, что модель отнесла к теме «проблемы с оплатой» 18 утверждений, люди — 11, а при ручной проверке 7 из 18 оказались жалобами на промокоды. Это не галлюцинация в чистом виде, а размытая граница кода, и лечится она уточнением определения. А вот тема, у которой при проверке не находится ни одной дословной цитаты, лечится только удалением.
Результат такого сравнения стоит оформить одной страницей и приложить к любому AI-синтезу, который команда потом делает на этом типе данных. Это ваша внутренняя калибровка.
Вывод: что делать с этим завтра
Перестаньте задавать модели вопрос «какие главные проблемы». Задавайте ей вопросы, на которые можно проверить ответ: разбей этот отзыв, найди цитату, отнеси к коду из списка. Числа считайте сами, редкое читайте сами, гипотезы проверяйте с двух сторон. Тогда экономия времени останется, а уверенность в выводах будет заслуженной.
Источники
Apple Machine Learning Research, «An LLM-Based Approach to Review Summarization on the App Store», 2025 — machinelearning.apple.com
Laban P., Fabbri A. R., Xiong C., Wu C.-S., «Summary of a Haystack: A Challenge to Long-Context LLMs and RAG Systems», EMNLP 2024 — arXiv:2407.01370
Liu N. F. et al., «Lost in the Middle: How Language Models Use Long Contexts», Transactions of the ACL, т. 12, 2024 — aclanthology.org
Zhang Y. et al., «Fair Abstractive Summarization of Diverse Perspectives», NAACL 2024 — aclanthology.org
Sharma M. et al., «Towards Understanding Sycophancy in Language Models», 2023 — arXiv:2310.13548
Dai S.-C., Xiong A., Ku L.-W., «LLM-in-the-loop: Leveraging Large Language Model for Thematic Analysis», Findings of EMNLP 2023 — aclanthology.org
Иван Лапа — продакт-менеджер в Uzum Tezkor (Ташкент). Ранее работал над продуктами для курьеров в Яндекс Pro. Пишет о продуктах доставки и о работе с AI в продукте и исследованиях.
Мнение автора может не совпадать с позицией компании, в которой он работает.
Смотрите на эту тему
Вам не поверят на слово: как заработать доверие с помощью социального доказательстваКак исправить репутацию бренда для нейросетейПочему бизнес начинает терять клиентов еще до перехода на сайт и как это исправитьЖалоба как точка роста: как клиентский сервис превращается в источник повторных продаж в B2BКомментарии
Проверяем вход…
Подпишитесь на нашу рассылку и получите 3 дня бесплатного доступа к PRO-аккаунту Pressfeed
Будем присылать самые актуальные материалы, полезные советы и эксклюзивные кейсы
 Примеры пресс-релиза для прессы. Как написать цепляющий пресс-релиз и где разместить его бесплатно